Speculative Decoding 是什麼
Speculative Decoding(推測解碼)是一種用來加速大語言模型推理的技術。核心想法很直觀:找一個小而快的模型(俗稱 draft model)先猜出接下來幾個 token,再讓大模型一次驗證整串猜測。猜對的部分直接採用,猜錯的位置由大模型接手。兩者不是排隊等,而是有點像工廠產線的分工。
業界常看到的加速效果大約落在 2-4 倍,具體數字會依任務性質、配對模型、硬體環境而變。Google DeepMind 與 vLLM、llama.cpp 等開源社群的實測都指向同一個方向:這個方法確實有效,而且不需要犧牲輸出品質。
為什麼需要 Speculative Decoding
本地推論最大的瓶頸不是模型參數量,而是 token 生成時的「自迴歸」特性——每一個 token 都必須等前一個算完才能開始。大模型跑一個 token 要幾十毫秒,但 GPU/NPU 其實大部分時間在空等。如果有個小模型能預先猜出 3-5 個 token,大模型一次驗證,等於把空窗期填滿。
這個思路不是新發明,Google 在 2022 年就提出 SpecDec 系列論文。真正讓它變成實用技術,是近兩年開源推論框架(vLLM、llama.cpp、MLX)陸續內建或支援 draft model 機制,門檻大幅降低。
Draft Model 與 Target Model 的配對邏輯
配對不是隨便挑小模型就好,幾個原則:
- 同源優先:用同系列的小模型配大模型,token 分布最接近,命中率最高
- 能力落差不能太大:draft model 太笨會一直猜錯,驗證成本反而吃掉加速紅利
- 權重格式相容:兩者最好用同一套 tokenizer 和權重格式,避免轉檔損耗
實務上常見的配對像是 Qwen2.5-0.5B-Instruct 配 Qwen2.5-7B-Instruct、Llama-3.2-1B 配 Llama-3.1-8B,命中率通常能到 60-80%。
Speculative Decoding 的運作原理
核心流程拆解
整個過程可以拆成三步:
- Draft 階段:小模型自迴歸生成 K 個候選 token(例如 K=4 或 K=8)
- Verify 階段:大模型平行處理這 K 個 token,一次 forward pass 算出所有位置的 logits
- Accept/Reject:逐個比對機率分布,接受通過的 token,第一個失敗的位置由大模型重新採樣
關鍵在第 2 步——大模型不是一個一個 token 算,而是「一次算完」K 個位置的機率。這是平行化的精髓,也是為什麼需要足夠的 VRAM 或 unified memory 來批次處理。
Lossless 的保證來自哪裡
很多人擔心:讓小模型先猜會不會犧牲品質?答案是:不會。
原因是驗證階段使用的是大模型的 logits,不是直接接受小模型的選擇。當 draft token 的機率分布落在 target model 的合理範圍內,就採用;不落在,就用 target model 自己的採樣結果替換。數學上可以證明,最終輸出分布與原生自迴歸採樣完全一致,這也是為什麼這類實作會標榜「lossless」。
vLLM 與 llama.cpp 的整合現況
vLLM 的 Speculative Decoding
vLLM 從 0.4 版開始把 speculative decoding 做成正式功能,透過 --speculative-model 參數指定 draft model,常見用法:
vllm serve meta-llama/Llama-3.1-8B-Instruct \
  --speculative-model meta-llama/Llama-3.2-1B-Instruct \
  --num-speculative-tokens 5
優點是 PagedAttention 已經把 KV cache 管理得很漂亮,多 draft token 不會爆記憶體;缺點是 vLLM 主要綁 NVIDIA GPU,Apple Silicon 上跑不起來。
llama.cpp 的 Speculative Decoding
llama.cpp 把這功能叫做「speculative sampling」,透過 --model-draft 參數啟用,支援 GGUF 格式的 draft model。社群維護了一份常用配對清單,涵蓋 Mistral、Qwen、Llama 三大主流系列。
對本地部署來說,llama.cpp 是目前最成熟的選擇,因為:
- 跨平台(macOS、Linux、Windows)
- 量化支援完整(Q4、Q5、Q8)
- Metal、CUDA、Vulkan 後端齊全
DFlash:Apple Silicon 上的 Lossless 推論加速器
什麼是 DFlash?
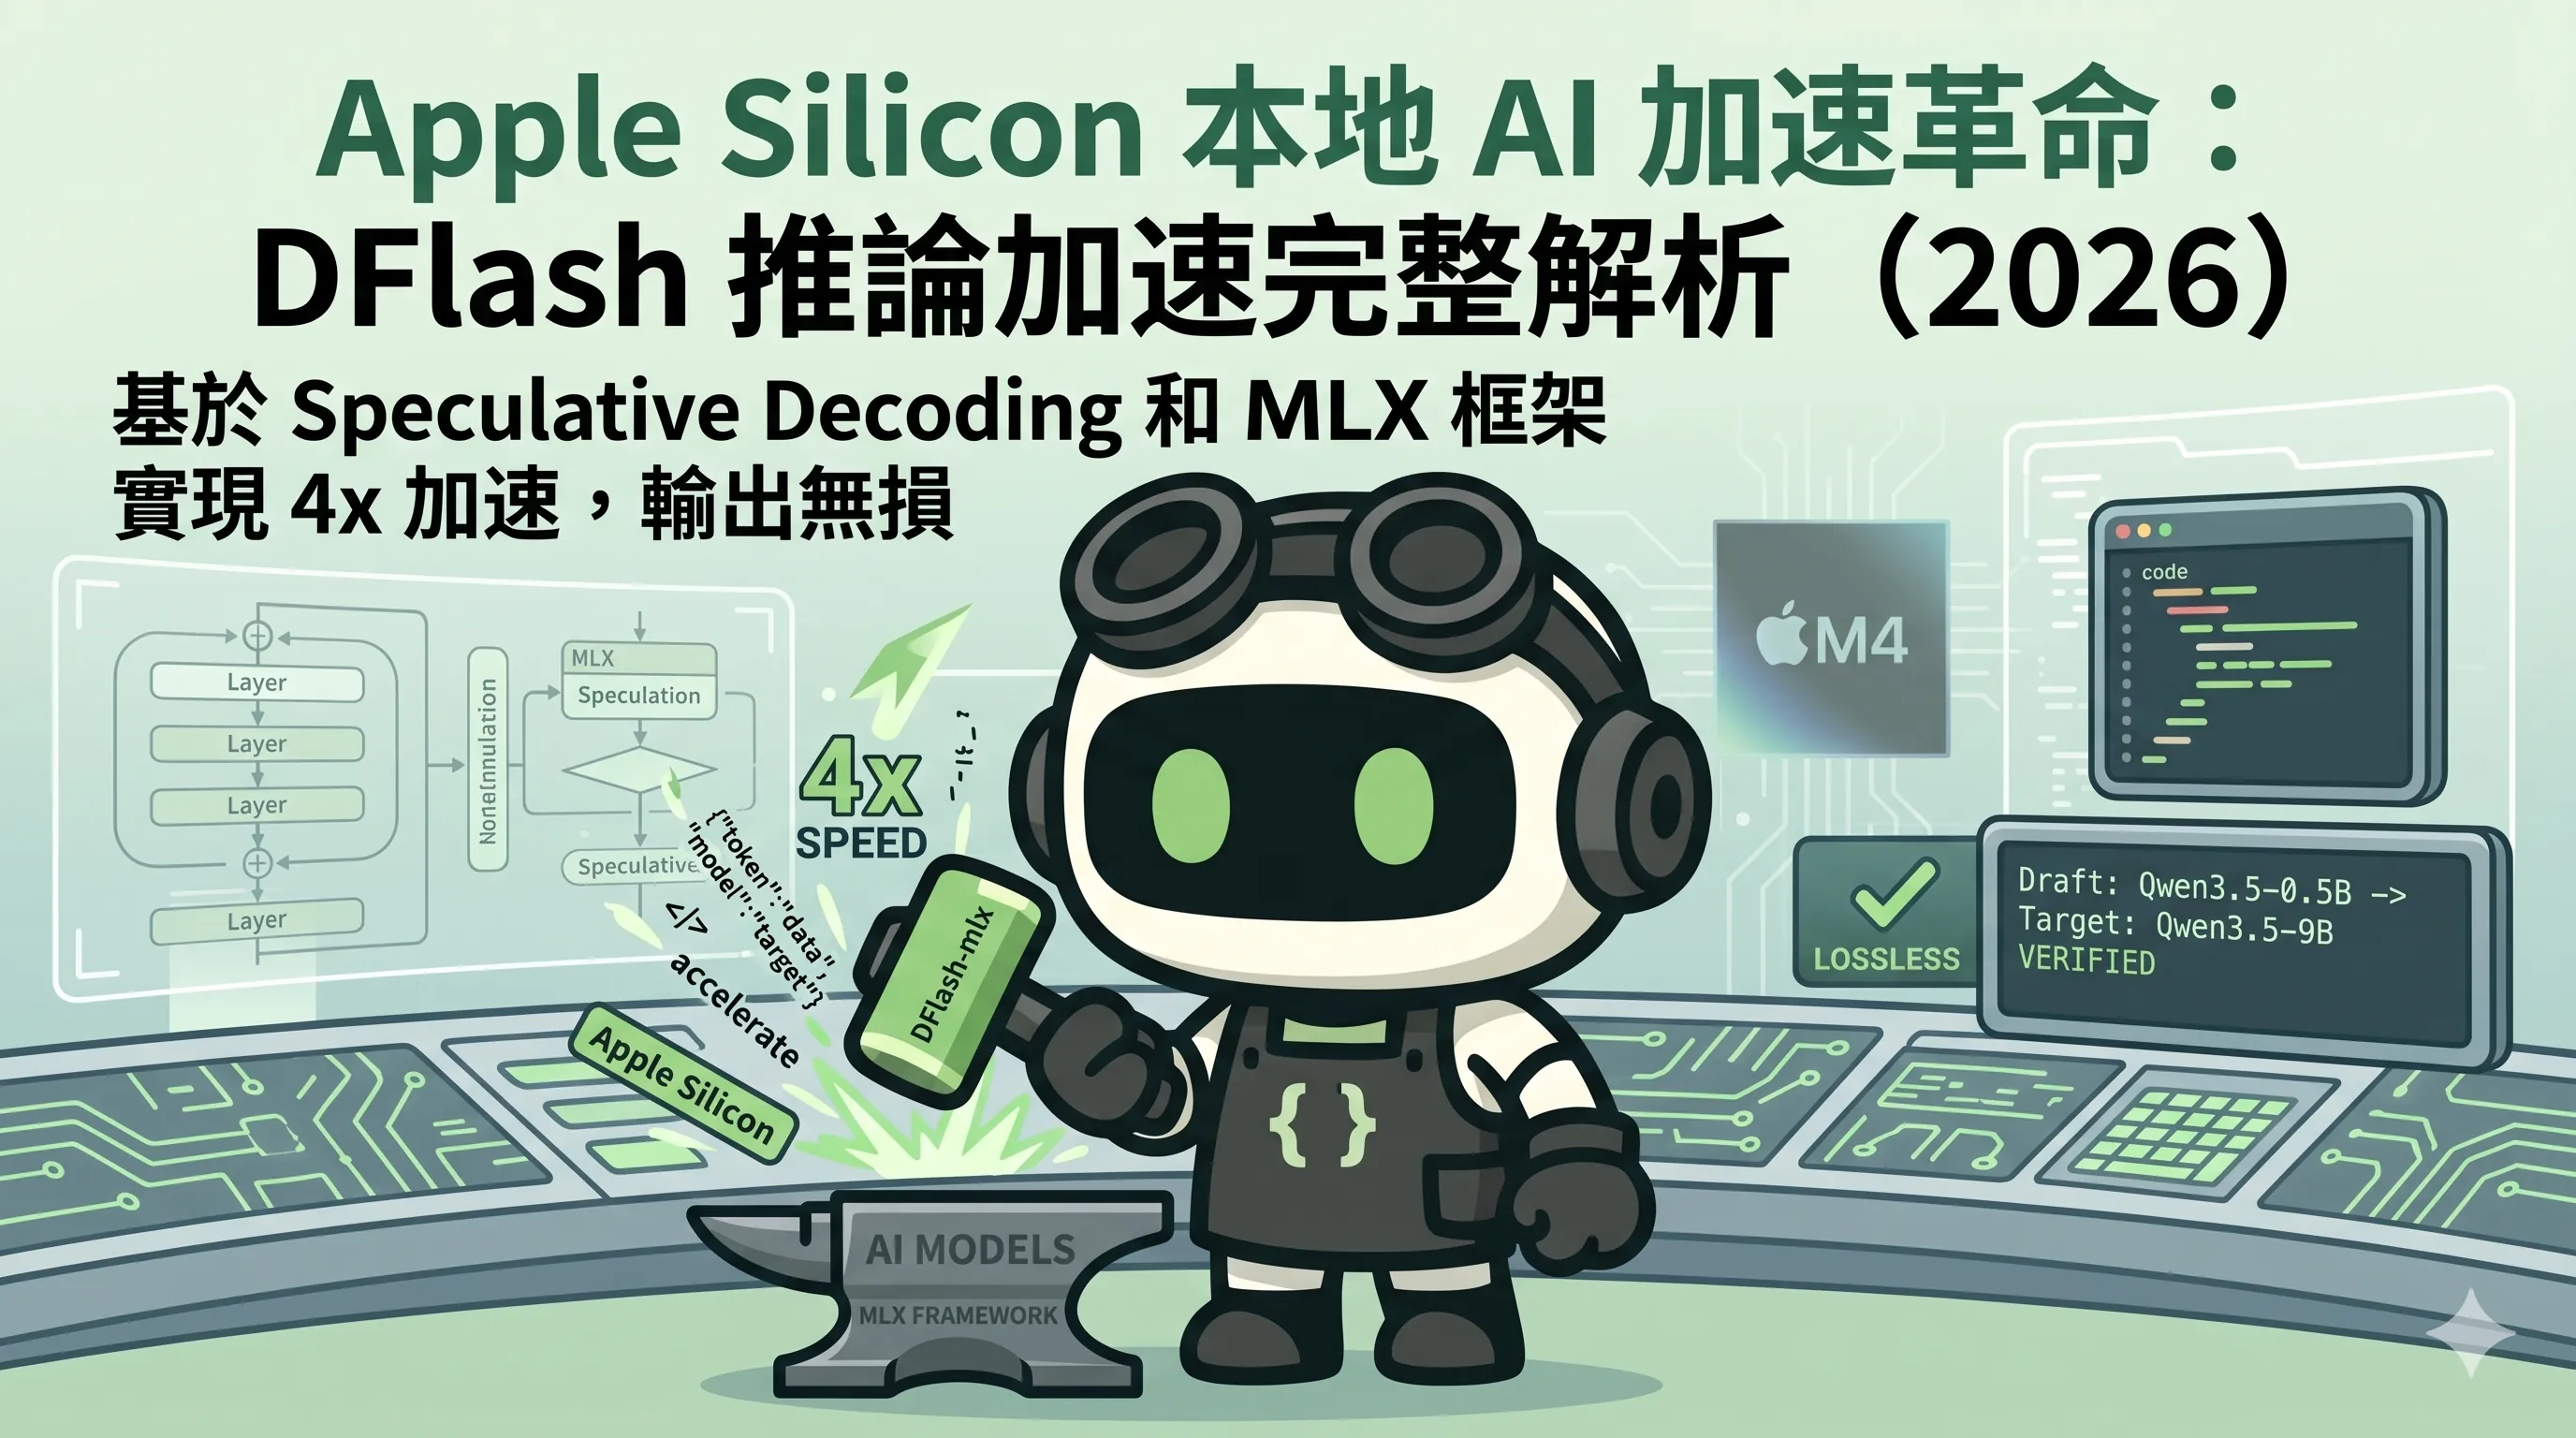
DFlash(Lossless DFlash)是開源工具,作者 bstnxbt 把它做成 MLX 框架的推論加速器,專門給 Apple Silicon 用。設計底層來自 speculative decoding 這個老概念,但這次做到了真正的 lossless——draft model 丟出來的每一個 token,都會被 target model 親自驗證一遍,輸出品質跟原生推論完全一致,不會偷工減料。
GitHub 專案在 bstnxbt/dflash-mlx。
為什麼 Apple Silicon 需要另一套實作?
vLLM 在 NVIDIA GPU 上很強,但 Mac 用戶根本跑不動;llama.cpp 雖然有 Metal 後端,speculative decoding 在 Mac 上的最佳化還不算完善。DFlash 直接基於 Apple 官方的 MLX 框架開發,能吃滿 M1/M2/M3/M4 的 unified memory 架構,記憶體共享的優勢讓大模型 + draft model 同時載入不再是難事。
DFlash 的技術特點
- 純 MLX 實作:不需要額外依賴,跟 mlx-lm 推論流程無縫整合
- Lossless 保證:每個 draft token 都經過 target model 驗證,輸出分布數學等價
- Unified Memory 友善:draft 與 target 共用同一塊記憶體,省去 PCIe 傳輸
- 開源可改:程式碼規模不大,想自訂 draft 策略或換配對模型都容易
實際部署流程
## 安裝 MLX
pip install mlx-lm

## 複製 DFlash 專案
git clone https://github.com/bstnxbt/dflash-mlx
cd dflash-mlx

## 執行推論(指定 target 與 draft model)
python -m dflash_inference \
  --target-model mlx-community/Qwen2.5-7B-Instruct \
  --draft-model mlx-community/Qwen2.5-0.5B-Instruct
Apple Silicon 用戶最常問的問題是「我的 MacBook Air 跑得動嗎?」答案是:8B 等級的模型在 M2 以上、16GB unified memory 的環境就能跑,DFlash 因為有 draft model 輔助,token/s 通常比原生 mlx-lm 提升 1.5-3 倍不等,視 prompt 長度與模型配對而定。
MLX、llama.cpp、Core ML 怎麼選?
Apple Silicon 上的本地推論框架主要有三條路線:
MLX(Apple 官方)
- 優勢:Apple 原生框架,unified memory 設計,吃滿 M 系列晶片
- 生態:mlx-lm、mlx-vlm 已是主流,DFlash 等加速器都基於此
- 限制:社群規模比 PyTorch 小,遇到坑要自己爬
llama.cpp(社群主流)
- 優勢:跨平台、GGUF 格式、量化成熟、speculative decoding 支援
- 生態:最多人用、模型最多、相關工具鏈最完整
- 限制:Metal 後端雖然有,但深度最佳化比不上 MLX
Core ML(Apple 封閉生態)
- 優勢:iOS/macOS 原生整合,能跑在 iPhone 上
- 生態:需要經過轉檔,模型庫相對少
- 限制:speculative decoding 這類動態策略不好實作
選型建議
| 場景 | 建議框架 |
|---|---|
| MacBook/Mac Studio 跑開源 LLM | MLX + DFlash 或 llama.cpp |
| 想跨平台部署(Mac + Linux 伺服器) | llama.cpp |
| iOS App 內建推論 | Core ML |
| 純 NVIDIA GPU 伺服器 | vLLM |
2026 年本地 AI 推論的部署實戰
硬體需求評估
跑 Speculative Decoding 比純 target model 多一份 draft model 的記憶體。以 7B + 0.5B 配對為例,Q4 量化後大約需要:
- target model:~4.5 GB
- draft model:~0.4 GB
- KV cache 與工作空間:視 context length 而定
建議 Apple Silicon 起碼 16GB unified memory,32GB 會舒服很多。NVIDIA GPU 端則至少 12GB VRAM。
配對策略的實測經驗
命中率是加速效果的命脈,幾個觀察:
- 同家族配對命中率最高(同系列不同尺寸)
- 任務性質影響大:結構化輸出(JSON、程式碼)命中率通常高於開放式寫作
- Temperature 設定:低溫(0.0-0.3)配 deterministic sampling 命中率最好
- Draft token 數量:K=4 到 K=8 是甜蜜點,太長會浪費、太短沒效果
常見踩坑與排查
- 加速效果不如預期:檢查 draft model 是否同源、tokenizer 是否一致
- 記憶體不足:考慮降量化精度(Q8 → Q4)或縮短 context length
- 輸出品質異常:確認 verify 階段真的在跑,沒被某個 flag 關掉
Speculative Decoding vs 其他加速方案
| 技術 | 原理 | 品質影響 | 適用場景 |
|---|---|---|---|
| Speculative Decoding | 小模型預測 + 大模型驗證 | Lossless | 所有需要高保真輸出的場景 |
| 量化(Quantization) | 降低權重精度 | 可能微損 | 記憶體受限裝置 |
| KV Cache 壓縮 | 減少 attention 計算量 | 視實作而定 | 長 context 應用 |
| 模型蒸餾 | 訓練小模型模仿大模型 | 可能損 | 邊緣裝置、對品質容忍度高的場景 |
Speculative Decoding 最大優勢是不犧牲品質,這對企業應用尤其重要——沒人想為了快 2 倍而承擔輸出飄移的風險。