實作過本地 RAG 知識庫之後,多數人會遇到一個尷尬的問題:「怎麼知道它回答得好不好?」
建置階段有 metrics 可以看——chunk 數量、embedding 時間、API 回應速度。但這些都是系統面的指標,真正的問題是:你的 RAG 系統在回答使用者問題時,答案到底準不準?
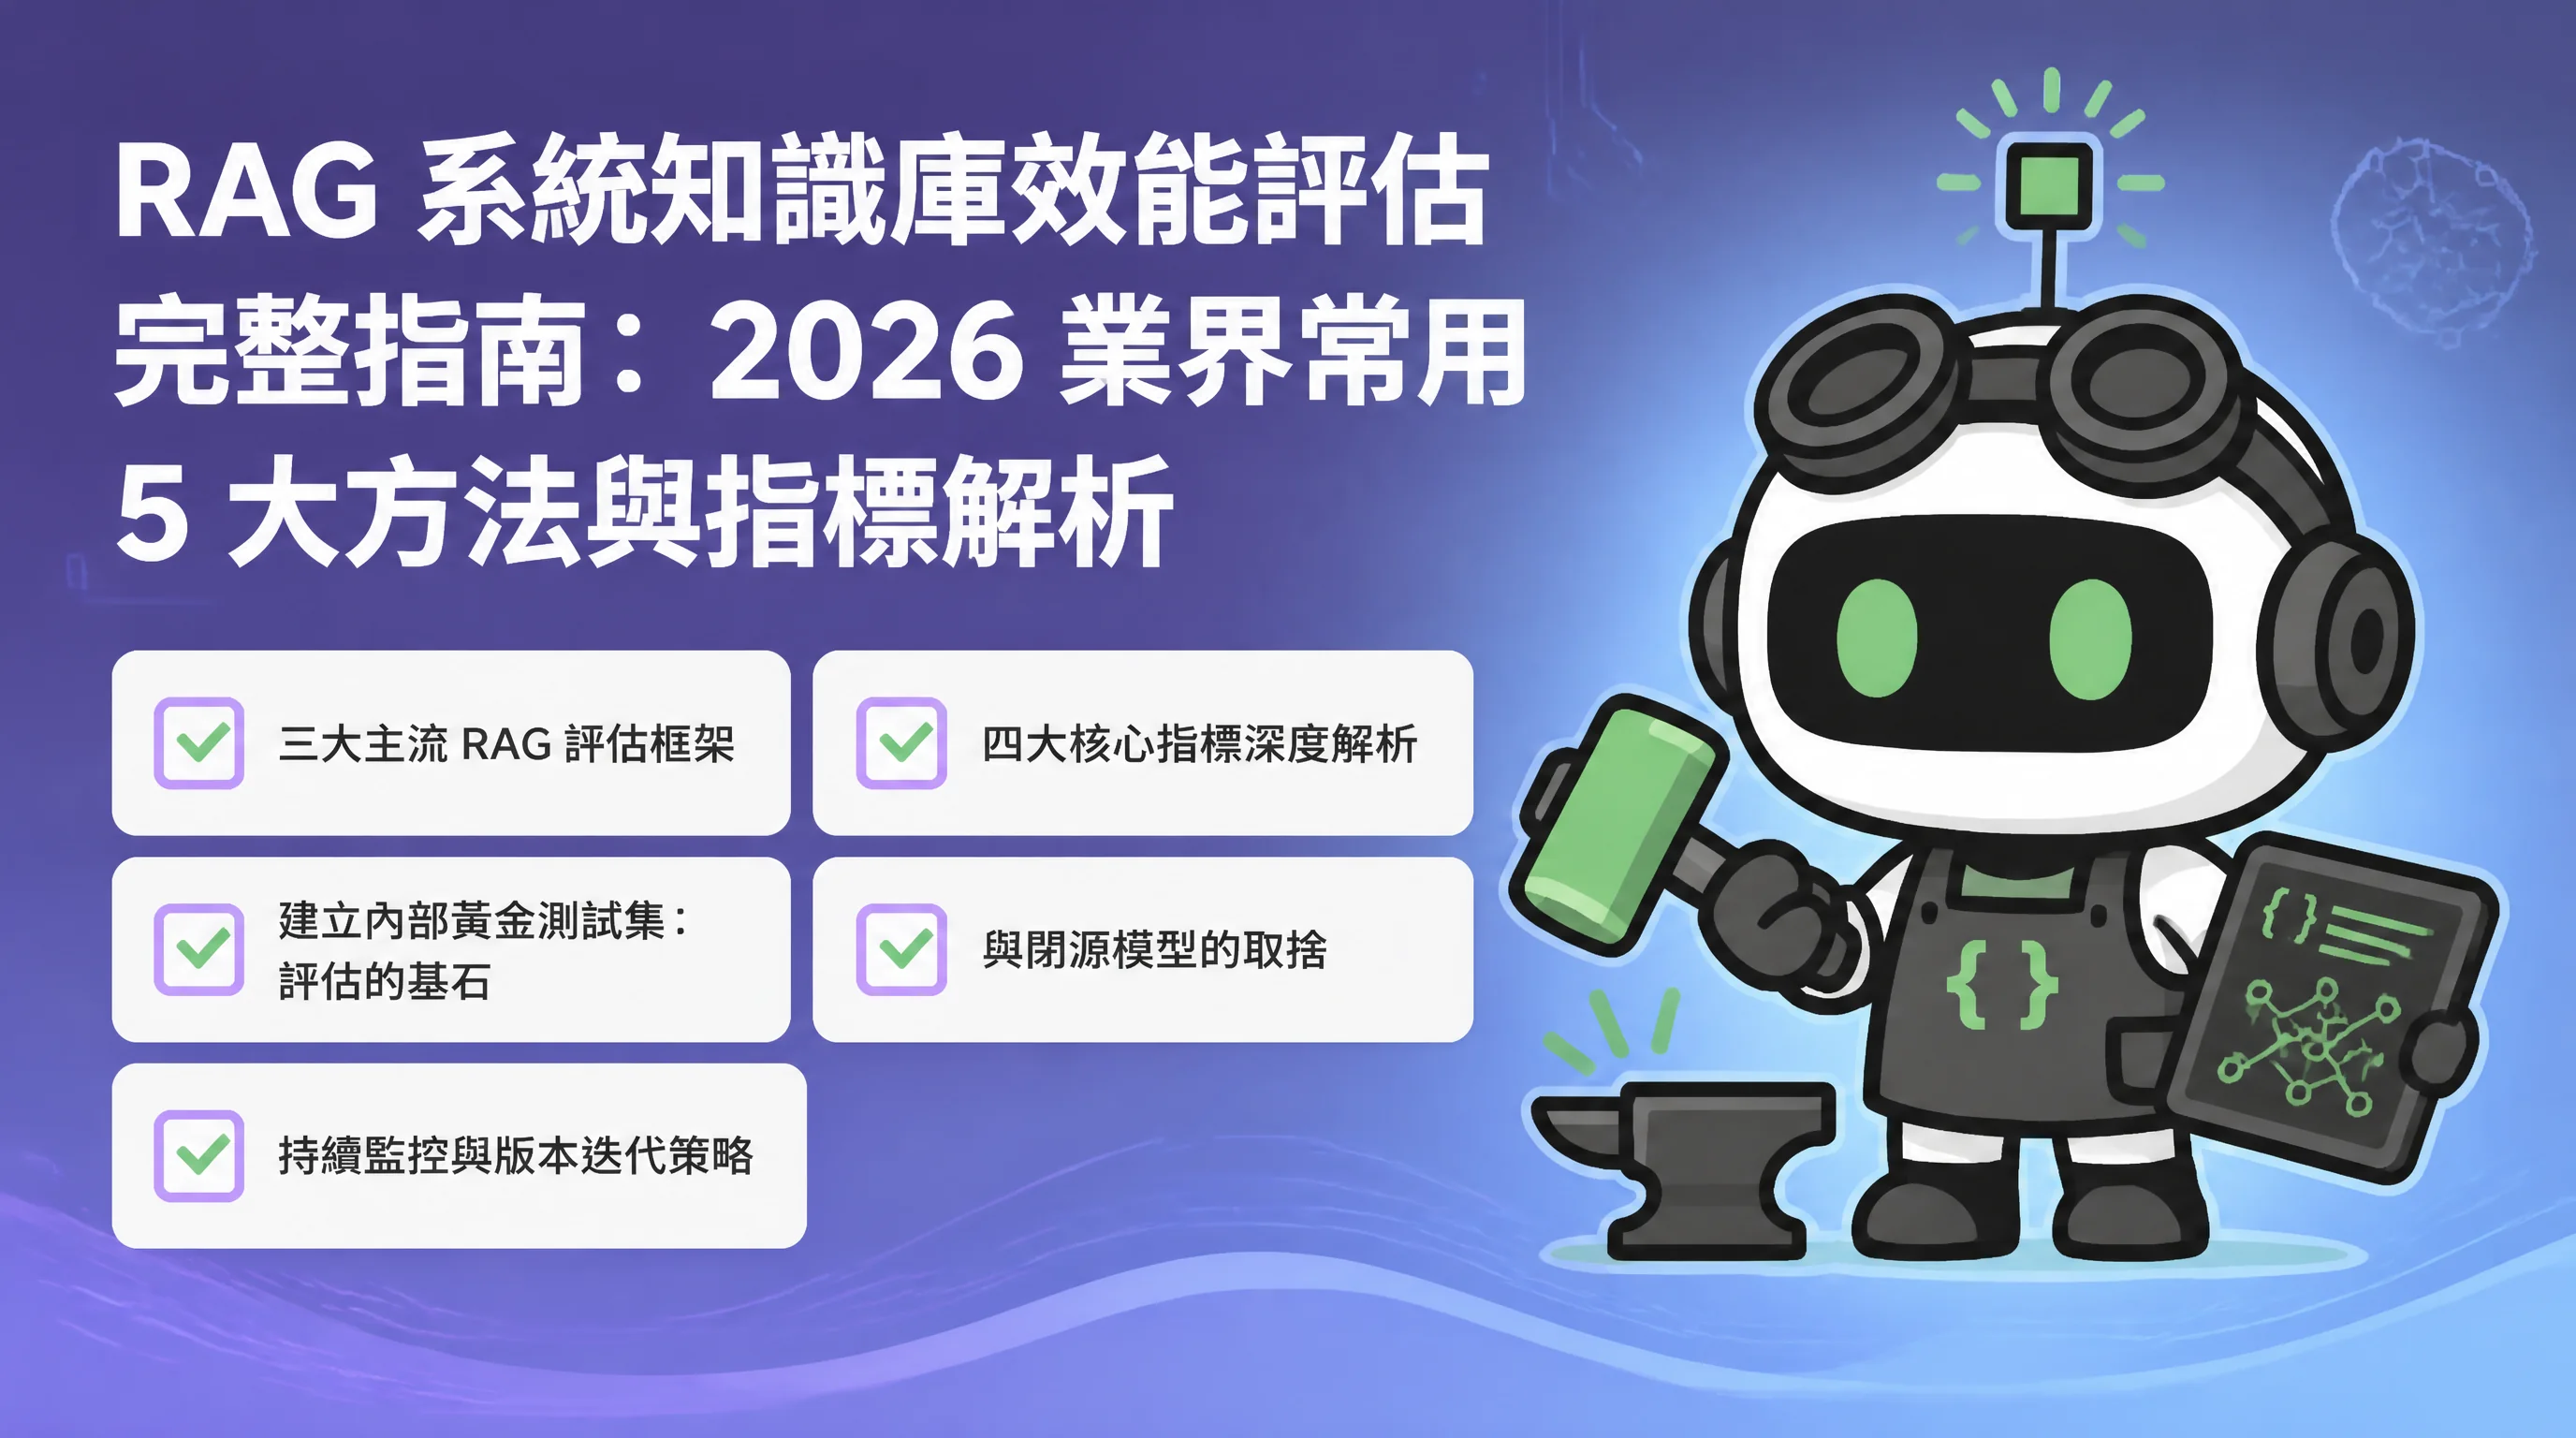
這篇文章要處理的,就是 RAG 評估這件事。我會用《用 OpenClaw 打造企業私有知識庫:RAG 實作完整指南》裡的同一套架構當範例,討論幾個在本地端切實可用的評估方法。讀完這篇,你會知道從 retrieval precision 到 hallucination rate,每個環節該怎麼測、測完怎麼改善。
為什麼 RAG 評估特別難
一般軟體測試有明確的對與錯:輸入 A,預期輸出 B,跑完測試看是否通過。
RAG 不一樣。同一個問題,知識庫文件 1% 的差距可能讓答案天差地遠。更麻煩的是,多數情況下「看起來回答了」不等於「回答正確」——系統可以很有信心地給出一個完全錯誤的數字或術語。
所以 RAG 評估的核心問題是:如何在沒有標準答案的情況下客觀測量「回答品質」?
評估維度:先搞清楚你要測什麼
在動手之前,先把 RAG 的錯誤類型分清楚。不同錯誤要用不同的指標來測。
第一層:檢索品質(Retrieval)
問題是「有沒有找到對的文件?」看的是 retrieval metrics——文件 chunk 相不相關,有沒有漏掉重要資料。如果這層錯了,後面再怎麼生成都是蓋大樓蓋在沙灘上。想深入了解檢索優化,可看RAG 檢索優化指南:為什麼別人的知識庫回答比你的精準?(2026)。想知道檢索端怎麼優化,可以看RAG 檢索優化指南:為什麼別人的知識庫回答比你的精準?(2026)。
第二層:生成品質(Generation)
問題變成「找到的資料有沒有好好回答?」看的是 generation metrics——答案是否引用了正確的 chunk,事實依據夠不夠。
第三層:幻覺率(Hallucination)
最後一道關卡:答案有沒有自己掰內容?這是最容易被忽略、也是傷害最大的問題。使用者以為得到的是事實,實際上是系統現編的——這種信任崩壞很難挽回。
多數評估工具測的是前兩層。但實務上,第三層才是能不能上 production 的關鍵。
評估資料集:測試問題夠不夠 representative?
多數 RAG 評估失效,是因為問題本身不夠全面。
設計測試集時,不要只靠團隊自己想問題。實務上更好的方式有三個來源:
第一個:實際使用者 query
從客服記錄、網站搜尋 logs、使用者研究訪談中收集真實提問。這些問題代樣真正的使用情境,不是想像出來的。
第二個:文件內容反推
把知識庫文件讀一遍,問自己「讀完這份文件,使用者會想問什麼?」這個方法可以抓到文件本身沒寫清楚的地方——通常是 hallucination 的高發區。
第三個:邊界案例
沒有涵蓋在文件裡的問題、含糊不清的問題、多意圖問題。這些問題雖然實際使用者也可能會問,但系統沒有正確答案是合理的。區分「合理的不知道」和「錯誤的回答」很重要。
實務建議:至少準備 50 個問題,分佈均勻。20% 簡單事實查詢、40% 需要理解後回答、20% 多跳推理(需要結合多個 chunk 的資訊)、20% 沒有標準答案的開放式問題或邊界問題。
Retrieval Metrics:你的 chunk 有沒有被正確檢索?
Precision@K 與 Recall@K
最直覺的指標。給系統一個問題,手動標記「正確的 chunk 有哪幾段」,然後看系統檢索回來的前 K 個 chunk 裡,正確的有幾個。
計算方式:
- Precision@K:檢索結果中,相關 chunk 所佔的比例。公式是「相關chunk數 / K」。如果前三名都是相關的,Precision@3 就是 1.0。
- Recall@K:所有相關 chunk 中,被檢索回來的比例。如果知識庫有 5 個相關 chunk,回來了 3 個,Recall@10 就是 0.6。
在純資訊檢索的場景,Recall@K 通常更重要——你要找到所有相關文件。但在 RAG 系統,如果 chunk 切得太碎,每個 chunk 只包含一個完整概念,Recall 的意義就會失真。這時候看 Hit Rate(前十筆至少找到一個相關的比率)會更實際。
Mean Reciprocal Rank(MRR)
當你要的是「第一個正確答案的排名」時,MRR 最合適。系統如果每次都把正確答案排在第一,MRR 就是 1.0;每次都墊底,趨近 0。公式是:MRR = (1/Q) × Σ(1/rank_i),Q 是問題總數,rank_i 是第 i 題第一個正確答案出現的位置。
實務上建議:對你的知識庫設計 20-50 個常見問題,每個問題標記正確 chunk,然後計算這組問題的 average Precision@K 和 MRR。這就是你的 retrieval baseline,之後調整 chunk size 或 embedding model 時,可以用同一組問題重新跑一遍做 A/B test。
調整 Retrieval 的實務方向
拿到 Precision@K 低分的時候,問題通常出在三個地方。
chunk size 顆粒度不對:太大切,相關內容被稀釋在同一個 chunk 裡,matching 分數低;太小切,相關概念被打散在不同 chunk,Recall 下降。建議測試 256、512、1024 tokens 不同的設定。
metadata 太少或太多:沒有 metadata 的 chunk,在複雜查詢時等同於大海撈針;但 metadata 太多又會讓系統學到用 metadata 而非內容本身做 matching。
embedding model 不適合你的領域:通用模型在法律、醫療、程式碼等專業領域樣現通常差一截。可以參考《2026 AI 封閉與開源 Embedding 模型推薦》,BQA-1.5 和 Qwen 系列在不同領域的樣現差異很大,選對模型對 retrieval quality 有直接影響。
Generation Metrics:答案有沒有好好回答?
RAGAS 評估框架
RAGAS 是一個專門給 RAG 系統的評估框架,不需要人工標記正確答案,純用 LLM 來判斷回答品質。三個核心指標:
- Faithfulness(忠實度):答案有沒有忠實於檢索到的文件內容。有沒有自己添加內容?即使答案看起來完全正確,只要有任何一個事實偏離了文件,就應該被扣分。
- Answer Relevancy(答案相關性):答案與問題的相關程度。系統有沒有答非所問?問的是 A,答案繞了一大圈才提到 A,這就是低相關性。
- Context Precision(上下文精確度):檢索回來的上下文,有多少跟答案真正相關。很多 chunk 被檢索回來了,但答案只用了其中兩句,這種就是 precision 低的訊號。
實作方式很簡單:
pip install ragas datasets
from ragas import evaluate
from ragas.metrics import faithfulness, answer_relevancy, context_precision
from datasets import Dataset

## 準備測試資料集
data = {
    "user_input": ["問題1", "問題2", ...],
    "retrieved_contexts": [["chunk1", "chunk2"], ["chunk3"], ...],
    "response": ["答案1", "答案2", ...],
    "ground_truth": ["標準答案1", "標準答案2", ...]
}

dataset = Dataset.from_dict(data)

result = evaluate(
    dataset,
    metrics=[faithfulness, answer_relevancy, context_precision]
)
RAGAS 的限制是:它用 LLM 當裁判,所以你的評估品質會受限於用來裁判的模型能力。用 GPT-4 當裁判,結論會比用本地小型模型可靠。同一個系統,用不同裁判模型可能跑出完全不同的分數,這點要有心理準備。
無框架的手動 fact check
不想架 RAGAS 的話,最基本的方式是:對每一個問題的答案,抽取 1-3 個具體聲明(claims),然後去 chunk 文件中驗證。
例如問題是「請說明我們的網站報價流程」,答案提到「初稿交付時間為兩週」,就去看 chunk 文件裡有沒有這個資訊。沒有的話,就是 hallucination。
可以自己做一個簡單的表格:
| 問題 | 答案提及的事實 | 來自哪個 chunk? | hallucination? |
|---|---|---|---|
| 公司電話是多少? | 04-2233-4455 | chunk_17 | ✅ 正確 |
| 服務項目有哪些? | 網站設計、SEO | chunk_3 | ✅ 正確 |
| 成立時間? | 2021年 | chunk_12 | ❌ 幻覺(實際是2023) |
這個表格做起來繁瑣,但每週跑一次、累積 30-50 筆之後,你就能算出 hallucination rate 有多少。這是最誠實的數字。
Hallucination Rate:最容易被忽略的指標
hallucination 不是「答錯」,是「答案看起來流暢合理,但內容是你自己掰的」。
這種錯誤最危險,因為系統給出答案時語氣通常很確定,一般使用者根本分辨不出來。一個工程背景的使用者,看到「React 16.8 發布於 2019 年 2 月」這個答案,可能直接相信了——但實際上正確時間是 2019 年 2 月,這個例子恰好對了;在另一個例子,系統說的是 2021 年,那就錯了。
實用的 hallucination 測試法
方法一:Claim Extraction + Fact Checking
對每個問題的答案,用 LLM 抽出 1-3 個具體 claims,然後獨立查驗每個 claim 是否來自檢索到的文件:
## 步驟一:從答案中抽取 claims
extract_prompt = """
你是一個事實查核員。請從以下答案中,
抽取所有可以被客觀驗證的具體聲明(claims)。
忽略主觀感受、情緒描述、以及模糊的陳述。

答案:我們的網站報價流程分三個階段,初稿大約兩週後交付,
      設計稿確認後進入開發階段,開發時間依功能複雜度約4-8週。

聲明:
1. 網站報價流程分三個階段
2. 初稿約兩週後交付
3. 設計稿確認後進入開發階段
4. 開發時間依功能複雜度約4-8週
"""

## 步驟二:對每個 claim 做 binary check
check_prompt = """
以下聲明是否可以直接從提供的文件內容中證實?
只回答「是」或「否」,不需要解釋。

文件內容:[chunk 文件文字...]
聲明:初稿約兩週後交付
答案:需要文件內容才能判斷
"""
方法二:對比 Reference 與答案
把檢索回來的所有 chunks 作為 reference,讓 LLM 對比答案與 reference,標記任何有出入的地方。這種方法比 claim extraction 更全面,但計算成本更高。
方法三:Self-Critique Prompt
用同一個 LLM(或另一個更強的模型),給它 prompt:「你是一個事實查核員,請根據以下檢索內容,判斷答案是否包含任何文件中未提及的資訊。如果有,請列出這些未被支持的聲明。」
這個方法的缺點是:當答案涵蓋多個 chunk 時,LLM 也很難完美地做到 fact checking,多數時候這種方法只能抓到「明顯的 hallucination」,對「細節摻假的灰色地帶」效果有限。
實務建議:紅區警告與 Threshold
如果你的 RAG 系統在「文件裡根本沒有答案」的問題上,經常自信地給出一個長篇大論——這就是 hallucination 的訊號。這類問題的比例,就是你系統最需要優先處理的數字。
建議設定內部 threshold:Faithfulness 低於 0.8 的答案,一律進人工審核區,不直接回給使用者。
結語:沒有銀彈,只有不斷測
RAG 評估沒有捷徑。最誠實的建議是:每週固定跑一次 evaluation report,用同一組問題、同一個裁判模型,追蹤分數的趨勢。Precision@K 從 0.6 進步到 0.7,比任何單次測試都更有意義。
發現系統 hallucination rate 超過 10%,就別急著上 production。數字會說話——只不過多數團隊在系統剛開始能跑出一個流暢答案的時候,就忘了這句話。
對於網頁設計公司而言,RAG 評估的意義在於:當你替客戶的網站建置 AI 客服功能,訪客對系統的信任取決於答案的準確度。如果知識庫檢索出錯,AI 會很流暢地給出錯誤答案——這種「有自信的錯誤」比「不知道」傷害更大。建立系統性的 RAG 評估習慣,是網站 AI 功能能否長期獲得用戶信任的關鍵。
如果你對 RAG 的底層建置有興趣,可以參考[《用 OpenClaw 打造企業私有知識庫:RAG 實作完整指南》](https://fordige.com/blog/openclaw-rag-knowledge-base-guide);選 embedding model 時的取捨,則推薦[《2026 AI 封閉與開源 Embedding 模型推薦》](https://fordige.com/blog/ai-embedding-model-recommendation-closed-vs-open),兩篇文章都提供了實作層面的具體建議。